+7 (844) 245-94-88
 pc@huananzhi.ru


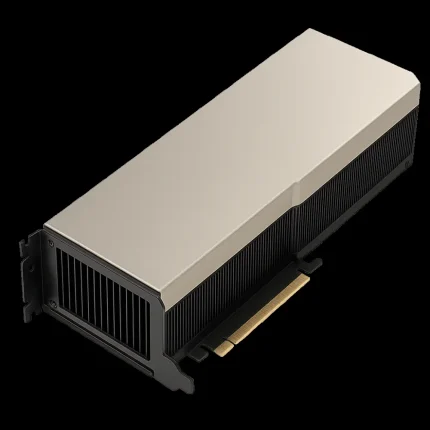
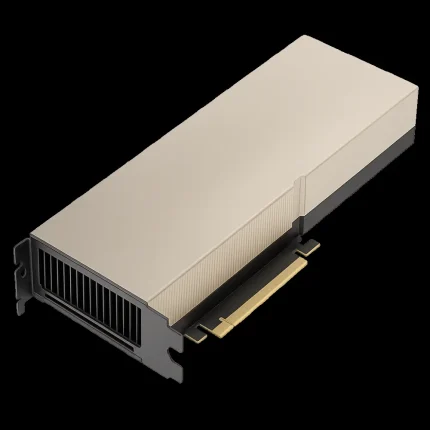
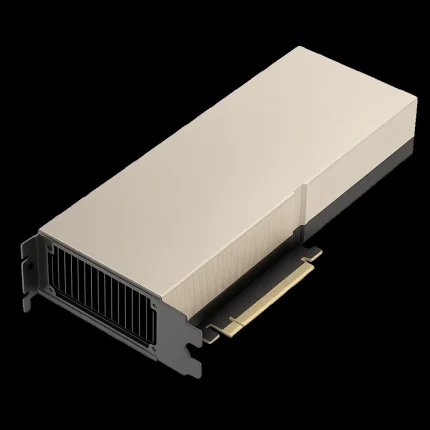
Вопрос «какая видеокарта нужна для ИИ» не имеет единого ответа: 24 ГБ VRAM хватит для одной задачи и будет катастрофически мало для другой. Выбор видеокарты для нейросетей определяется не брендом и не тактовой частотой, а тремя параметрами: объёмом видеопамяти, тем, что вы делаете (инференс или обучение), и размером модели. Ниже разобраны эти параметры по порядку, с ориентирами по VRAM под конкретные задачи и рекомендациями по выбору класса GPU под бюджет.
Почему для ИИ нужна именно видеокарта
Работа нейросети сводится к огромному количеству матричных умножений, которые выполняются параллельно. Центральный процессор оптимизирован под последовательные вычисления и содержит немного мощных ядер, а видеокарта устроена иначе: тысячи простых ядер одновременно перемножают числа. Для инференса и особенно для обучения это разница на порядки: задача, которая на CPU занимает часы, на GPU считается минутами.
Отдельная причина, по которой выбор для ИИ практически всегда падает на NVIDIA, это экосистема CUDA. Основные фреймворки машинного обучения (PyTorch, TensorFlow) и библиотеки инференса (vLLM, llama.cpp, TensorRT-LLM) оптимизированы в первую очередь под CUDA и аппаратные возможности видеокарт NVIDIA, такие как тензорные ядра. Карты других производителей формально способны считать нейросети, но требуют дополнительной адаптации софта, поэтому для рабочей задачи это решение почти всегда неоправданно.
Главный параметр выбора: объём видеопамяти VRAM
Если свести выбор видеокарты для ИИ к одному показателю, это объём VRAM в гигабайтах. Именно видеопамять, а не число ядер или частота, определяет:
- какого размера модель (в миллиардах параметров) поместится на карту целиком или потребует разбиения между несколькими GPU;
- какой длины контекст можно обрабатывать: KV-кэш растёт вместе с длиной промпта и диалога и занимает отдельную долю VRAM сверх весов модели;
- какой batch size доступен при обучении, что напрямую влияет на скорость и стабильность сходимости;
- в каком формате хранить веса: FP16/BF16 для точности или квантование INT8/INT4, чтобы модель уместилась в память ценой небольшой потери качества.
Мощность вычислительных ядер влияет на скорость обработки, но если модель не помещается в VRAM, видеокарта её попросту не запустит, вне зависимости от того, насколько она быстрая. Поэтому при подборе GPU для ИИ сначала считают объём видеопамяти под конкретную модель и только затем сравнивают производительность карт с достаточным объёмом.
Инференс против обучения: разные требования к видеокарте
Инференс: использование готовой модели
При инференсе видеокарта загружает в память только веса модели и KV-кэш под текущий контекст. Обратного прохода нет, градиенты и состояния оптимизатора хранить не нужно, поэтому требования к VRAM здесь минимальны из всех сценариев. Одна карта с 16-24 ГБ уверенно тянет модели среднего размера в квантованном виде, что делает инференс самым доступным сценарием для входа в тему.
Обучение и дообучение: требования растут кратно
Обучение модели требует в разы больше видеопамяти, чем инференс той же модели. На каждый параметр дополнительно к весам нужно хранить градиенты (примерно такой же объём, что и сами веса), состояния оптимизатора (например, Adam хранит два дополнительных тензора на параметр, что может удваивать-утраивать нагрузку) и активации промежуточных слоёв для обратного прохода, растущие вместе с batch size и длиной последовательности.
В сумме полное дообучение модели может требовать в 4-6 раз больше VRAM, чем её инференс. Поэтому для дообучения крупных моделей почти всегда нужен либо мульти-GPU сервер, либо техники экономии памяти вроде LoRA и QLoRA, которые обучают лишь небольшую добавочную часть весов и резко снижают требования к видеопамяти одной карты.
Ориентиры по размеру моделей и объёму VRAM
Грубое эмпирическое правило для инференса LLM в 16-битной точности: на 1 миллиард параметров модели требуется порядка 2 ГБ VRAM, плюс запас под контекст и служебные буферы. Квантование до INT8 или INT4 снижает эту цифру в 2-4 раза ценой небольшой просадки качества ответов. Ориентировочные пороги по классам моделей:
- 7-13B параметров: 16-24 ГБ VRAM для инференса в квантованном виде. Комфортно работает на одной потребительской видеокарте, это стартовая точка для большинства задач.
- 30-34B параметров: от 24 ГБ при агрессивном квантовании до 48 ГБ в более высокой точности. Уже имеет смысл смотреть на видеокарты старшего сегмента или младшие профессиональные карты.
- 70B и выше: одной картой обойтись почти невозможно. Нужна либо связка карт по 24-48 ГБ, либо ускорители с 80 ГБ VRAM класса H100 или A100, вмещающие такие модели меньшим числом карт.
- Крупные MoE-модели (архитектуры с большим числом экспертов): локальный запуск и тем более дообучение требует мульти-GPU сервера, где несколько карт объединяются, чтобы суммарной VRAM хватило на все активные веса.
Это ориентиры, а не гарантия: точная потребность в видеопамяти зависит от глубины квантования, длины контекста и архитектуры модели.
Таблица: задача ИИ → класс видеокарты и объём VRAM
| Задача ИИ | Класс видеокарты | Ориентир по VRAM |
|---|---|---|
| Инференс LLM 7-13B, чат-боты, локальные ассистенты | Потребительская RTX, одна карта | 16-24 ГБ |
| Генерация изображений, инференс LLM 30-34B | RTX старшего сегмента или младшая проф. карта | 24-48 ГБ |
| LoRA/QLoRA дообучение моделей 7-13B | Одна карта повышенной ёмкости VRAM | 24-48 ГБ |
| Инференс LLM 70B+, локальный запуск крупных MoE-моделей | Мульти-GPU связка или карты 80 ГБ | от 80 ГБ суммарно |
| Полное обучение и масштабное дообучение крупных моделей | A100/H100 с объединением через NVLink | 80 ГБ на карту, несколько карт |
| Обучение с нуля, промышленные ML-пайплайны | Кластер H100 (DGX-класс) | 8x 80 ГБ и выше |
Потребительские RTX против профессиональных A100/H100
Выбор между этими двумя классами видеокарт для ИИ определяется задачей, а не бюджетом как таковым.
- Потребительские и prosumer RTX. Оптимальный вход в тему: инференс небольших и средних языковых моделей, генерация изображений, LoRA-дообучение, работа с одной задачей на одной карте. Хорошее соотношение объёма VRAM и стоимости, но объединение нескольких таких карт для обучения ограничено пропускной способностью обычной шины PCIe.
- Профессиональные ускорители A100/H100. 80 ГБ быстрой HBM-памяти на карту и аппаратный NVLink, прямое высокоскоростное соединение между GPU в обход PCIe. Когда модель не помещается на одну карту, её веса распределяют между несколькими GPU, которые непрерывно обмениваются данными: NVLink снимает это узкое место и позволяет картам работать почти как единый ускоритель с суммарной видеопамятью. Выбор для моделей от 70B параметров, распределённого обучения и продакшн-нагрузок, где важна отказоустойчивость.
Актуальный подбор моделей по обоим классам собран в разделе профессиональных видеокарт для искусственного интеллекта.
Память и питание сервера под несколько видеокарт
Видеокарта остаётся центральным элементом расчёта, но система вокруг неё должна соответствовать нагрузке, иначе даже мощный GPU будет простаивать.
- Системная оперативная память. Для чистого инференса достаточно скромного объёма, поскольку данные живут в VRAM. Для обучения, особенно при выносе части весов или состояний оптимизатора в ОЗУ при нехватке VRAM, нужен запас от 128 до 512 ГБ на сервер, желательно модулями ECC/REG для стабильности при длительных вычислениях.
- Питание и охлаждение. Профессиональные ускорители и топовые RTX потребляют по несколько сотен ватт каждая, а в конфигурации из 4-8 карт суммарная нагрузка на блок питания и охлаждение сервера становится определяющим фактором надёжности. Занижение мощности блока питания под пиковую нагрузку нескольких карт приводит к нестабильности и перезагрузкам во время длительного обучения.
- Диски. Датасеты занимают от десятков до сотен гигабайт и должны читаться быстро, иначе видеокарты будут простаивать в ожидании данных. NVMe SSD является стандартом для рабочего каталога, HDD годится разве что для архивного хранения.
Готовые конфигурации серверов под несколько видеокарт с расчётом памяти и питания разобраны в статье про сервер для нейросетей, а полный ассортимент таких серверов доступен в разделе серверов для искусственного интеллекта.
Как выбрать видеокарту под задачу и бюджет
Практический алгоритм подбора видеокарты для ИИ сводится к нескольким последовательным шагам.
- Определите сценарий: инференс готовой модели или обучение/дообучение своей. Это сразу задаёт порядок требований к VRAM.
- Оцените размер целевой модели в параметрах и решите, использовать ли квантование INT8/INT4 или работать в точности FP16/BF16.
- Посчитайте VRAM с запасом: к весам прибавьте KV-кэш под нужную длину контекста, а для обучения дополнительно градиенты, состояния оптимизатора и активации.
- Решите, нужна ли одна карта или несколько. Если суммарный объём VRAM превышает возможности одной видеокарты, закладывайте мульти-GPU конфигурацию, с NVLink для обучения.
- Выберите класс карты: потребительская RTX для инференса и LoRA-дообучения или ускоритель A100/H100 для моделей от 70B и промышленного обучения.
- Проверьте баланс системы: оперативную память, мощность блока питания и охлаждение сервера под выбранное число карт.
- Заложите запас на рост: модели и контекст со временем растут, поэтому карта с запасом по VRAM окупается быстрее, чем апгрейд впритык под текущую задачу.
Ошибка в сторону недостаточного объёма видеопамяти обходится дороже, чем экономия на вычислительной мощности: медленная карта просто считает дольше, а карта с нехваткой VRAM не запустит модель вовсе или заставит урезать контекст и batch size до непригодных значений. Мы подбираем видеокарты и серверные конфигурации для инференса и обучения нейросетей под конкретный сценарий заказчика, от одной карты для локального ассистента до мульти-GPU сервера с NVLink под обучение крупных моделей. Если не уверены, какой объём VRAM и какой класс карты нужен под ваши модели, опишите задачу (размер моделей, инференс или обучение, число пользователей), и мы подберём конфигурацию в разделе профессиональных видеокарт для искусственного интеллекта.
Перед покупкой посчитайте VRAM не только под веса модели, но и под KV-кэш при максимальной длине контекста, которую реально планируете использовать: на длинных диалогах кэш способен занять больше памяти, чем сами веса квантованной модели. Если бюджет ограничен, начните с квантования INT8 и оцените просадку качества на своих данных, прежде чем закладывать более дорогую карту с большим объёмом памяти. Для мульти-GPU обучения проверяйте не только объём VRAM каждой карты, но и пропускную способность соединения между ними: без NVLink несколько карт, объединённых через PCIe, заметно теряют в скорости синхронизации градиентов.
Квантизация и требуемый объём VRAM
Требование к VRAM определяется не только числом параметров модели, но и точностью их хранения. Базовая формула: VRAM_весов ≈ params × bits / 8 × 1.1 (10% на оверхед).
- FP16/BF16 — 16 бит на параметр. Llama-3 8B ≈ 16 ГБ весов, 70B ≈ 140 ГБ.
- INT8 — 8 бит. 8B ≈ 8 ГБ, 70B ≈ 70 ГБ. Потери качества обычно
- INT4 (GPTQ, AWQ, GGUF Q4_K_M) — около 4.5 бита. 8B ≈ 4.5 ГБ, 70B ≈ 40 ГБ.
- Q2/Q3 — 2–3 бита, заметная деградация на reasoning-задачах, используется только под крайне жёсткие лимиты.
Оверхед идёт на KV-кэш и активации. Для Llama-3-8B KV-кэш в FP16 ≈ 0.125 МБ на токен: 8K токенов ≈ 1 ГБ, 32K ≈ 4 ГБ. Для 70B умножьте примерно на 9.
Практический вывод: квантизация в 4 бита сжимает модель в 3–4 раза и позволяет загрузить 70B на одну RTX 4090 24 ГБ вместо пары A100 40 ГБ. Но на обучении всё жёстче: QLoRA считает в NF4 с 4-битными весами и FP16-адаптерами, полноценный fine-tune требует BF16 и памяти в 4–6 раз больше весов. На инференсе Q4 снижает throughput на 10–30% относительно FP16 при том же железе, потому что ядра распаковывают веса на лету.
PCIe и пропускная способность при нескольких GPU
Когда модель не помещается на одну карту, включается tensor parallelism: слои режутся между GPU, и на каждом слое идёт обмен активациями. Здесь решает уже не VRAM, а шина.
- PCIe 4.0 x16 — 32 ГБ/с в одну сторону.
- PCIe 5.0 x16 — 64 ГБ/с.
- NVLink (A100) — 600 ГБ/с, H100 — 900 ГБ/с.
- RTX 4090 — NVLink нет, только PCIe.
Если слот физически x4 Gen3 (8 ГБ/с), multi-GPU обучение проседает в 2–5 раз, а инференс с tensor parallelism теряет 30–60% от ожидаемого. Для двух карт минимум — x8 Gen4 на каждую, для четырёх и более — x16 Gen4/Gen5 или NVLink-бридж.
Проблема серверных платформ: 128 линий PCIe делятся между CPU, NVMe, сетевыми картами и GPU. У двухсокетных плат часть слотов привязана к одному сокету, и трафик между картами разных сокетов идёт через UPI. Проверяйте топологию: nvidia-smi topo -m покажет NV#, PIX, PHB, SYS. Для tensor parallel нужны PIX/NV#, SYS — плохой знак. Если линии в дефиците, используйте PCIe-свитчи (PLX, Broadcom) или riser с внешним питанием.
Блок питания и охлаждение под multi-GPU
Считайте бюджет мощности по формуле: (сумма TDP GPU × 1.3) + CPU TDP + 200 Вт на систему. Коэффициент 1.3 нужен из-за транзиентов: RTX 4090 с TDP 450 Вт выдаёт пики до 900 Вт на миллисекунды, и без запаса БП уходит в защиту под нагрузкой.
| GPU | TDP | 4 шт., с запасом |
|---|---|---|
| RTX 4090 | 450 Вт | ~2850 Вт |
| RTX 6000 Ada | 300 Вт | ~2050 Вт |
| A100 PCIe | 300 Вт | ~2050 Вт |
| H100 SXM | 700 Вт | ~4150 Вт |
Для четырёх 4090 реально берут два БП по 1600 Вт или серверный 3000 Вт Platinum/Titanium. 12VHPWR/12V-2×6 на 4090: один кабель = 600 Вт, не разветвляйте один выход БП на две карты.
Охлаждение: потребительские карты в плотной сборке дуют горячим воздухом друг в друга, между ними нужно ≥2 слота. Для серверных пассивных карт (A100/H100 SXM, L40S) требуется шасси с продувом 40–50 CFM на карту, иначе троттлинг с 80°C и потеря 20–30% производительности. Держите GPU ниже 80°C, hotspot — ниже 95°C. В стойке на 4 GPU нужен корпусный поток не менее 300 CFM и вытяжка наружу, а не рециркуляция внутри.
Локальная покупка против аренды облачных GPU
Цены аренды (2024–2025): RTX 4090 ≈ $0.3–0.5/час, A100 80 ГБ ≈ $1.5–2.5/час, H100 80 ГБ ≈ $2–3.5/час (RunPod, Lambda, vast.ai, Yandex Cloud). Покупка: 4090 ≈ $1800–2200, A100 80 ГБ PCIe ≈ $10000–15000, H100 ≈ $25000–30000.
Точка окупаемости 4090: 2000 / 0.4 ≈ 5000 часов, это около 7 месяцев непрерывной загрузки 24/7. A100 при $12000 и $2/час — 6000 часов, около 8 месяцев. Плюс электричество: 4090 под нагрузкой ≈ 400 Вт, при $0.15/кВт·ч это ~$43/месяц на карту.
Когда выгодно облако:
- разовые эксперименты и пиковые прогоны обучения на 1–2 недели;
- нужен доступ к H100/H200, которых нет в рознице или они дороже задачи;
- нет серверной, питания и охлаждения под 2–4 кВт.
Когда выгодно локально:
- загрузка стабильно выше 50–60%;
- данные нельзя вывозить (медицина, финансы, госсектор);
- нужен постоянный инференс с низкой задержкой и без почасовой оплаты;
- большие датасеты на локальных NVMe без оплаты egress.
Рабочая схема — гибрид: 1–2 локальные карты под инференс и QLoRA, облако — под крупные прогоны full fine-tune.
Частые ошибки при выборе видеокарты для ИИ
- Выбор карты по числу ядер CUDA или тактовой частоте без проверки, помещается ли целевая модель в её объём VRAM целиком.
- Расчёт видеопамяти только под веса модели без учёта KV-кэша, что приводит к нехватке памяти при увеличении длины контекста уже после покупки.
- Попытка дообучения модели на карте, рассчитанной под инференс: обучение требует в 4-6 раз больше VRAM из-за градиентов, состояний оптимизатора и активаций.
- Объединение нескольких потребительских карт через обычный PCIe для обучения крупной модели без учёта потерь скорости из-за отсутствия NVLink.
Частые вопросы
Сколько VRAM нужно для запуска модели на 7 миллиардов параметров?
Почему обучение требует намного больше видеопамяти, чем инференс?
Обязательно ли покупать A100 или H100 для локальных задач?
Что даёт NVLink по сравнению с обычным PCIe между картами?
Что из этого можно купить
В наличии, с доставкой по России